Google suma dos chips a su octava generación de TPU (y ya son cuatro configuraciones en un mismo año)
Las nuevas TPU 8tx y TPU 8i Max apuntan a la IA confidencial y a contextos de hasta un millón de tokens, en plena carrera por la infraestructura para agentes autónomos.
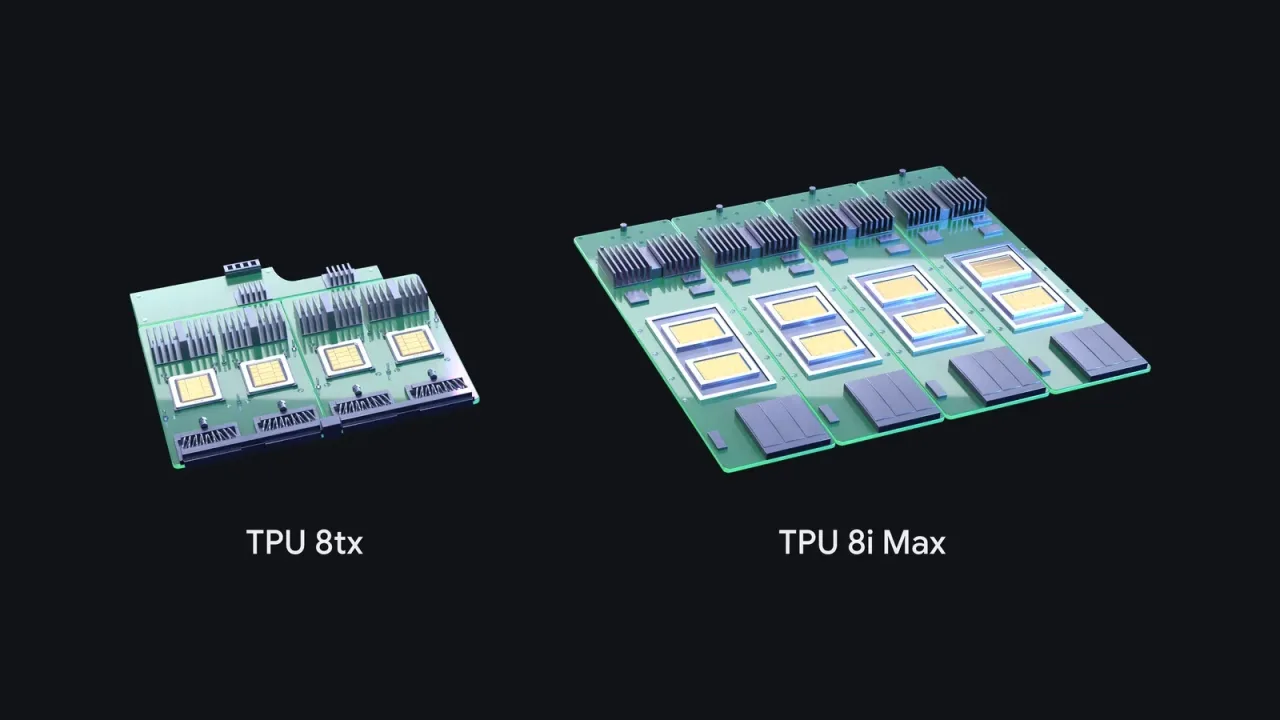
Google amplió su familia de TPU de octava generación con dos sistemas nuevos: la TPU 8tx y la TPU 8i Max. Es la primera vez que la compañía lanza cuatro configuraciones de sus unidades de procesamiento tensorial en un solo año. Cada una cubre una etapa distinta del ciclo de vida de la inteligencia artificial.
Las TPU se convirtieron en un negocio en plena expansión para Google. La empresa las usa para entrenar y correr sus modelos Gemini, las ofrece a los clientes de Google Cloud y, más recientemente, permite instalarlas directamente en los centros de datos de los propios clientes. Hoy suma cerca de 100 clientes, entre ellos laboratorios de IA de vanguardia, firmas de trading, cadenas minoristas y universidades.
Las dos primeras piezas de esta generación se presentaron en Cloud Next, en abril. La TPU 8t está orientada al entrenamiento de grandes modelos fundacionales y ofrece hasta 2,7 veces más rendimiento que las generaciones anteriores. La TPU 8i funciona como motor de razonamiento: mejora un 80 % la relación precio-rendimiento en inferencia y reduce a la mitad las demoras en la comunicación entre chips. Ahora, con las empresas llevando agentes autónomos a producción, Google desarrolló dos variantes para resolver dos problemas puntuales: la seguridad de los datos a nivel de hardware y el manejo de contextos masivos.
Para Amin Vahdat, Chief Technologist y Senior Vice President de IA e Infraestructura de Google, la computación está pasando «de una escala centrada en el ser humano a una escala basada en agentes», y eso obliga a contar con aceleradores capaces de razonar sobre ventanas de contexto enormes. Según el ejecutivo, además, los clientes de sectores muy regulados piden capacidades de cifrado especializadas. La apuesta, junto con los recientes anuncios vinculados a PyTorch, es hacer que las TPU sean más accesibles para desarrolladores y combinar silicio modular con un stack de software abierto para lanzar hardware nuevo al ritmo que pide la industria.
La TPU 8tx está pensada para gobiernos y empresas reguladas que trabajan con modelos propietarios y datos sensibles. Normalmente la información se cifra cuando se almacena o viaja por la red, pero tiene que descifrarse en memoria para poder procesarse. Este sistema, construido sobre el mismo silicio que la TPU 8t y combinado con hosts basados en CPU AMD personalizadas, integra la seguridad en el hardware y mantiene protegidos los datos y los pesos de los modelos incluso mientras están en uso. Al sumar la red Boardfly, creada para inferencia en tiempo real, logra la mitad de latencia que la TPU 8t prácticamente sin perder rendimiento. Esto permite ajustar modelos con datos privados, destilar modelos grandes en otros más chicos y entrenar agentes con aprendizaje por refuerzo sin mover información confidencial entre clústeres.
La TPU 8i Max, en cambio, ataca el llamado «muro de memoria»: cuando decenas de agentes trabajan a la vez sobre todo un código fuente o sobre horas de video, el ancho de banda de memoria se vuelve el cuello de botella. La solución fue integrar dos chips TPU 8i en un único encapsulado, lo que duplica la capacidad de cómputo, la memoria SRAM y el ancho de banda HBM respecto de la TPU 8i. Como mete el doble de silicio en el mismo espacio de rack, los centros de datos obtienen bastante más potencia por metro cuadrado y por vatio.
Con estas incorporaciones, la octava generación queda armada así: la TPU 8t para entrenamiento a gran escala, la TPU 8i para razonamiento de baja latencia, la TPU 8tx para computación confidencial y la TPU 8i Max para ventanas de contexto masivas y máxima densidad de cómputo por rack.